视频监控 · 跨时长人物检索 · 本地部署
视频人物跨时长快速检索:
从一闪而过的背影,精确找到他
给一段几十小时的视频,标定一个只出现几秒钟、甚至只有一个背影的人——系统用姿态、衣着、人脸等特征建索引,之后上传一张截图,几秒钟内在全部视频里定位这个人的每一次出现。
1255维多模态特征
外观692 + 姿态51 + 人脸512
3种识别模态
衣着 / 姿态关键点 / 人脸
8 → 2一闪而过 8 段碎片
合并为 2 段连续结果
0.25s按需切片播放
2 秒片段瞬时返回
 目标示例:蓝衣女 · 可用于检索的全身截图
01 · 背景与挑战
为什么这件事很难
目标极短暂
一闪而过,检出帧不足
很多目标每次只出现 0.2~0.5 秒(2~8 帧)。按常见"隔 N 帧检测一次 + 最少连续 M 帧"的建库策略,这类目标会被当成噪声直接丢弃——这就是"搜蓝衣返回一堆黄衣"的根因。
画面质量差
小、模糊、只有背影
目标框宽可能只有 30~50 像素,人脸不可用、姿态残缺。必须靠"衣着颜色 + 外观整体特征"兜底,而不是单一依赖人脸。
数据量大
几十小时视频
逐帧人脸识别不现实。需要"离线建索引 + 在线检索"的两段式架构,把重计算前置,检索阶段只做向量匹配。
原始视频不能动
播放要按需、按段
不能为了播放把整段视频转码。定位到目标后,只切片返回目标出现的那个小片段;同一人多次闪现时,跳过中间无人的画面。
02 · 系统架构
两段式:离线建索引,在线做检索
整体分为「建库」与「检索」两条流水线,共享同一个特征引擎和向量库。
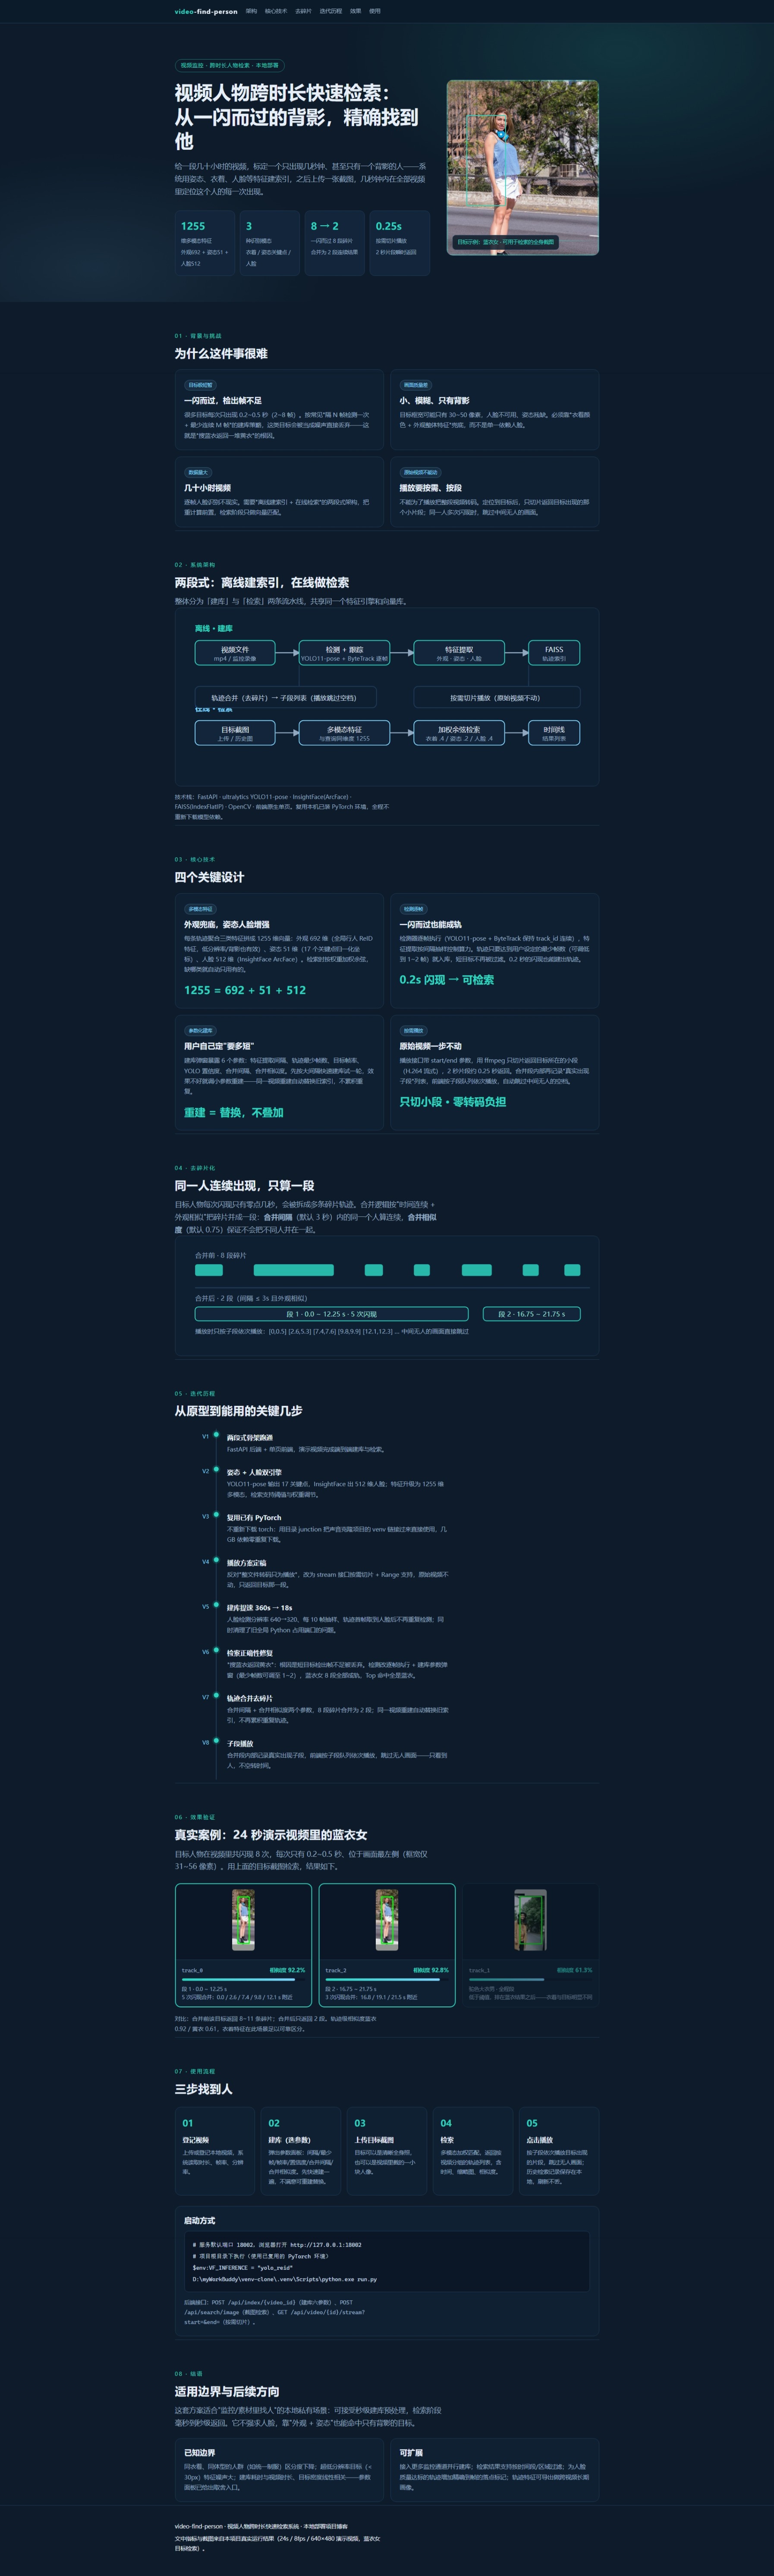
离线 · 建库视频文件mp4 / 监控录像检测 + 跟踪YOLO11-pose + ByteTrack 逐帧特征提取外观 · 姿态 · 人脸FAISS轨迹索引在线 · 检索目标截图上传 / 历史图多模态特征与查询同维度 1255加权余弦检索衣着 .4 / 姿态 .2 / 人脸 .4时间线结果列表轨迹合并(去碎片)→ 子段列表(播放跳过空档)按需切片播放(原始视频不动)
技术栈:FastAPI · ultralytics YOLO11-pose · InsightFace(ArcFace) · FAISS(IndexFlatIP) · OpenCV · 前端原生单页。复用本机已装 PyTorch 环境,全程不重新下载模型依赖。
03 · 核心技术
四个关键设计
多模态特征
外观兜底,姿态人脸增强
每条轨迹聚合三类特征拼成 1255 维向量:外观 692 维(全局行人 ReID 特征,低分辨率/背影也有效)、姿态 51 维(17 个关键点归一化坐标)、人脸 512 维(InsightFace ArcFace)。检索时按权重加权余弦,缺哪类就自动只用有的。
1255 = 692 + 51 + 512
检测逐帧
一闪而过也能成轨
检测器逐帧执行(YOLO11-pose + ByteTrack 保持 track_id 连续),特征提取按间隔抽样控制算力。轨迹只要达到用户设定的最少帧数(可调低到 1~2 帧)就入库,短目标不再被过滤。0.2 秒的闪现也能建出轨迹。
0.2s 闪现 → 可检索
参数化建库
用户自己定"要多短"
建库弹窗暴露 6 个参数:特征提取间隔、轨迹最少帧数、目标帧率、YOLO 置信度、合并间隔、合并相似度。先按大间隔快速建库试一轮,效果不好就调小参数重建——同一视频重建自动替换旧索引,不累积重复。
重建 = 替换,不叠加
按需播放
原始视频一步不动
播放接口带 start/end 参数,用 ffmpeg 只切片返回目标所在的小段(H.264 流式),2 秒片段约 0.25 秒返回。合并段内部再记录"真实出现子段"列表,前端按子段队列依次播放,自动跳过中间无人的空档。
只切小段 · 零转码负担
04 · 去碎片化
同一人连续出现,只算一段
目标人物每次闪现只有零点几秒,会被拆成多条碎片轨迹。合并逻辑按"时间连续 + 外观相似"把碎片并成一段:合并间隔(默认 3 秒)内的同一个人算连续,合并相似度(默认 0.75)保证不会把不同人并在一起。
合并前 · 8 段碎片合并后 · 2 段(间隔 ≤ 3s 且外观相似)段 1 · 0.0 ~ 12.25 s · 5 次闪现段 2 · 16.75 ~ 21.75 s播放时只按子段依次播放:[0,0.5] [2.6,5.3] [7.4,7.6] [9.8,9.9] [12.1,12.3] … 中间无人的画面直接跳过
05 · 迭代历程
从原型到能用的关键几步
V1
两段式骨架跑通
FastAPI 后端 + 单页前端,演示视频完成端到端建库与检索。
V2
姿态 + 人脸双引擎
YOLO11-pose 输出 17 关键点,InsightFace 出 512 维人脸;特征升级为 1255 维多模态,检索支持阈值与权重调节。
V3
复用已有 PyTorch
不重新下载 torch:用目录 junction 把声音克隆项目的 venv 链接过来直接使用,几 GB 依赖零重复下载。
V4
播放方案定稿
反对"整文件转码只为播放",改为 stream 接口按需切片 + Range 支持,原始视频不动,只返回目标那一段。
V5
建库提速 360s → 18s
人脸检测分辨率 640→320、每 10 帧抽样、轨迹首帧取到人脸后不再重复检测;同时清理了旧全局 Python 占用端口的问题。
V6
检索正确性修复
"搜蓝衣返回黄衣":根因是短目标检出帧不足被丢弃。检测改逐帧执行 + 建库参数弹窗(最少帧数可调至 1~2),蓝衣女 8 段全部成轨,Top 命中全是蓝衣。
V7
轨迹合并去碎片
合并间隔 + 合并相似度两个参数,8 段碎片合并为 2 段;同一视频重建自动替换旧索引,不再累积重复轨迹。
V8
子段播放
合并段内部记录真实出现子段,前端按子段队列依次播放,跳过无人画面——只看到人,不空转时间。
06 · 效果验证
真实案例:24 秒演示视频里的蓝衣女
目标人物在视频里共闪现 8 次,每次只有 0.2~0.5 秒、位于画面最左侧(框宽仅 31~56 像素)。用上面的目标截图检索,结果如下。

track_0相似度 92.2%
段 1 · 0.0 ~ 12.25 s
5 次闪现合并:0.0 / 2.6 / 7.4 / 9.8 / 12.1 s 附近

track_2相似度 92.8%
段 2 · 16.75 ~ 21.75 s
3 次闪现合并:16.8 / 19.1 / 21.5 s 附近

track_1相似度 61.3%
驼色大衣男 · 全程段
低于阈值,排在蓝衣结果之后——衣着与目标明显不同
对比:合并前该目标返回 8~11 条碎片;合并后只返回 2 段。轨迹级相似度蓝衣 0.92 / 黄衣 0.61,衣着特征在此场景足以可靠区分。
07 · 使用流程
三步找到人
登记视频
上传或登记本地视频,系统读取时长、帧率、分辨率。
建库(选参数)
弹出参数面板:间隔/最少帧/帧率/置信度/合并间隔/合并相似度。先快速建一遍,不满意可重建替换。
上传目标截图
目标可以是清晰全身照,也可以是视频里截的一小块人像。
检索
多模态加权匹配,返回按视频分组的轨迹列表,含时间、缩略图、相似度。
点击播放
按子段依次播放目标出现的片段,跳过无人画面;历史检索记录保存在本地,刷新不丢。
启动方式
# 服务默认端口 18002,浏览器打开 http://127.0.0.1:18002
# 项目根目录下执行(使用已复用的 PyTorch 环境)
$env:VF_INFERENCE = "yolo_reid"
D:\myWorkBuddy\venv-clone\.venv\Scripts\python.exe run.py
后端接口:POST /api/index/{video_id}(建库六参数)、POST /api/search/image(截图检索)、GET /api/video/{id}/stream?start=&end=(按需切片)。
08 · 结语
适用边界与后续方向
这套方案适合"监控/素材里找人"的本地私有场景:可接受秒级建库预处理,检索阶段毫秒到秒级返回。它不强求人脸,靠"外观 + 姿态"也能命中只有背影的目标。
已知边界
同衣着、同体型的人群(如统一制服)区分度下降;超低分辨率目标(< 30px)特征噪声大;建库耗时与视频时长、目标密度线性相关——参数面板已给出取舍入口。
可扩展
接入更多监控通道并行建库;检索结果支持按时间段/区域过滤;为人脸质量达标的轨迹增加精确到帧的落点标记;轨迹特征可导出做跨视频长期画像。
video-find-person · 视频人物跨时长快速检索系统 · 本地部署项目博客
文中指标与截图来自本项目真实运行结果(24s / 8fps / 640×480 演示视频,蓝衣女目标检索)。